

English | 中文


做 LLM 应用开发,专注 RAG 与 Agent 的端到端落地。做过完整链路:文档解析 → 切片 → Embedding → 检索 → Prompt → 生成 → 引用溯源 → API → 前端。
比起把模型调通,我更擅长定位 LLM 的非显性失效——那些不报错、但输出已经脱离依据的问题,并为它们设计防复发的兜底与回归测试。
| 方向 | 技术 |
|---|---|
| LLM 应用 | LangGraph · LangChain · ReAct · Function Calling · Prompt 工程 |
| 检索 RAG | BGE-M3 · FAISS · BM25 · 混合检索 · 引用溯源 |
| 后端 | Python 异步 · FastAPI · Uvicorn · REST · WebSocket |
| 前端 | React 19 + TypeScript · Vite · Tailwind CSS · ECharts |
| 工程化 | Docker Compose · pytest · pre-commit · Poetry / pip |
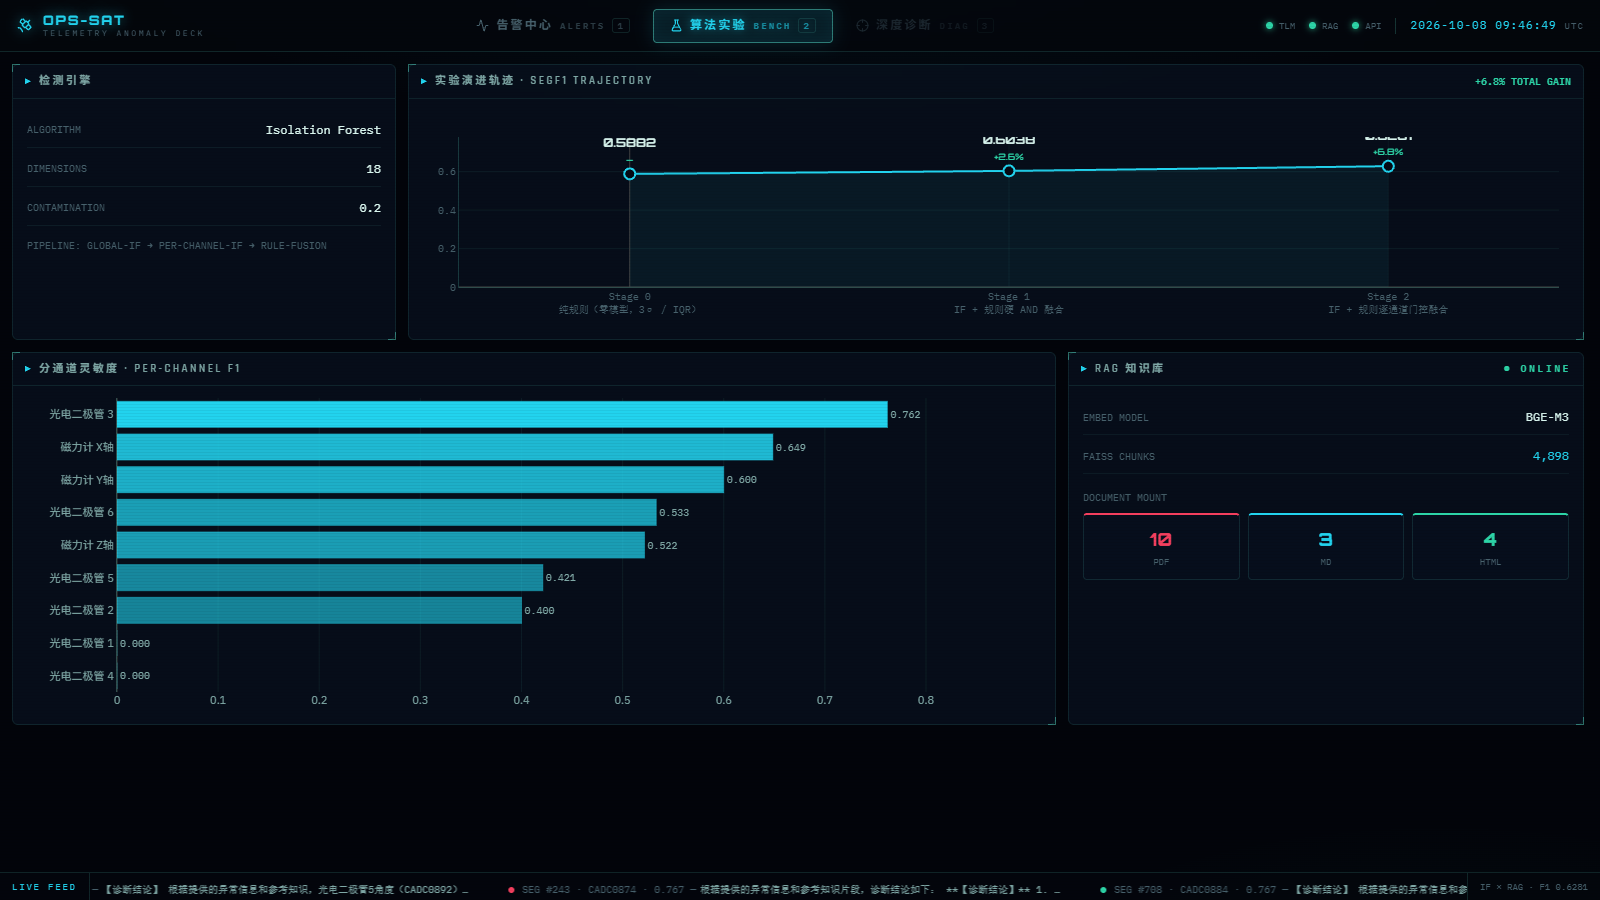
| 算法 | Isolation Forest · 特征工程 · 规则引擎门控融合 · 评测指标设计 |
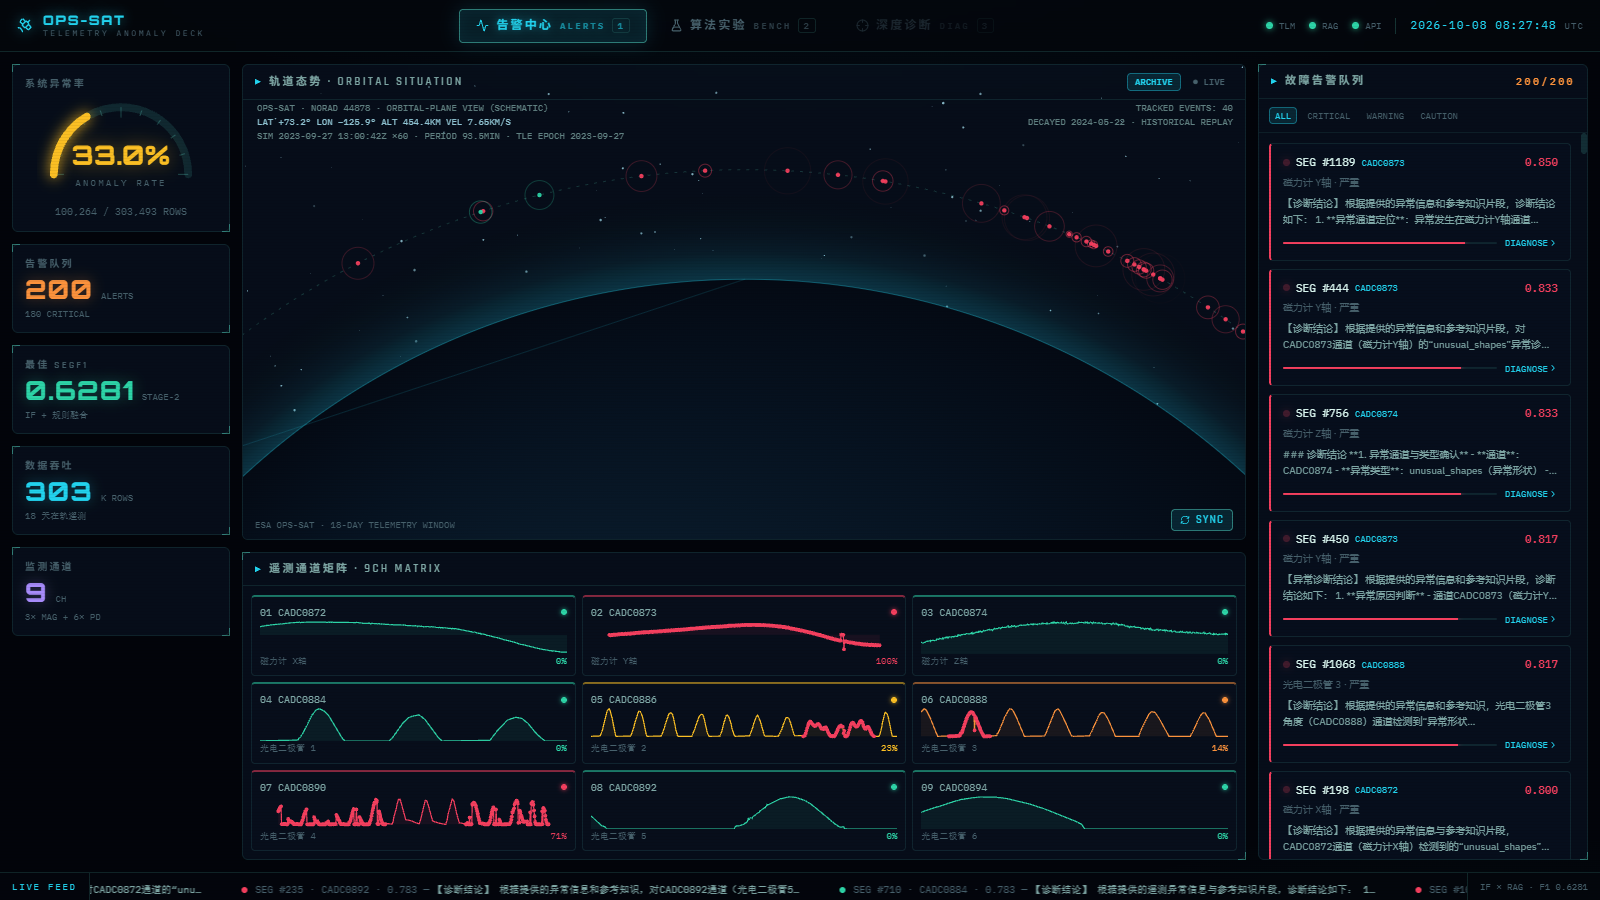
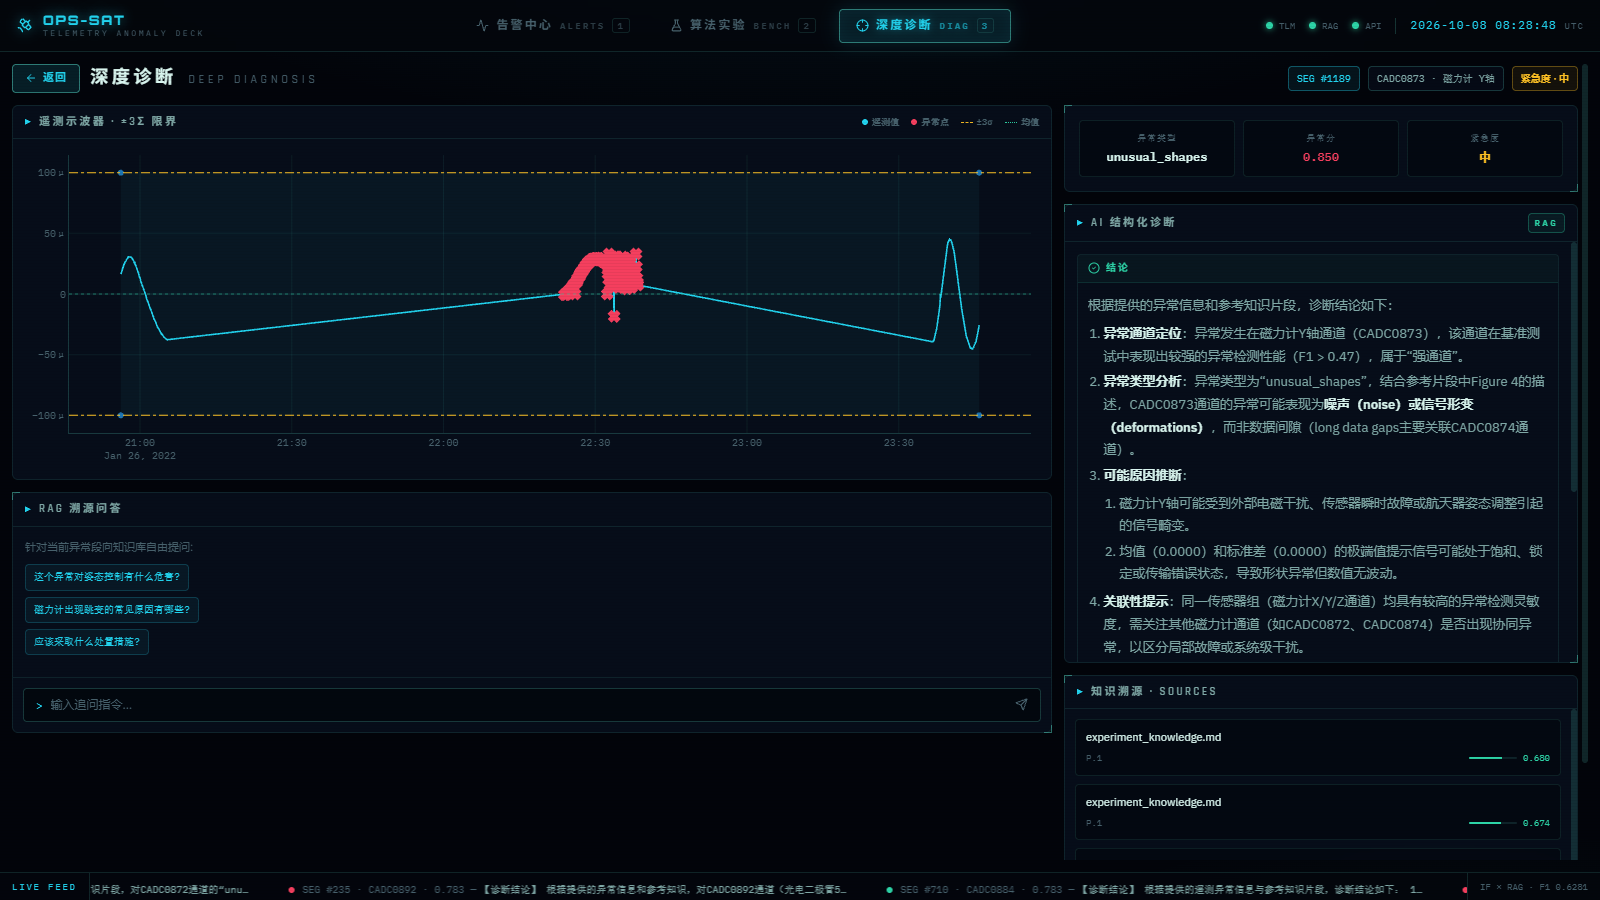
基于 ESA OPS-SAT 公开数据集(30.3 万行采样点 / 2123 段 / 9 通道)。用 Isolation Forest 检出异常段,再用 RAG 结合卫星手册知识库让 LLM 给出可溯源的异常解释。上海电机学院大学生创新创业训练计划项目,任项目负责人。
| 指标 | 结果 |
|---|---|
| 段级 F1 | 0.5882 → 0.6281(+6.8%) |
| 告警误报 | 20 → 0 |
| RAG 引用溯源 | 200 / 200 |
| 检索中位耗时 | 25 ms |
- 工程取舍:为把检索中位耗时压到 25 ms,主动放弃在线增量写入、改为离线重建索引;代价是知识库更新需重建,收益是检索路径极简、延迟可控。
- 修复非显性 AI 缺陷:「防幻觉提示词已写入但未生效」——生成内容脱离检索依据而系统无任何报错;用断言校验定位根因后,补上「检索不到即拒答」兜底与回归测试。
- 指标口径治理:段级与点级异常率分母不同、不可混用,两套口径单独出文档约束,避免跨口径比大小。
- 交付形态:FastAPI + React 19 前后端分离,含实时数据接入(
/api/stream/ingest+ WebSocket 告警)、API 认证与限流、SQLite 告警持久化。
仓库:https://github.com/Jerry518520/microsat-anomaly-analysis
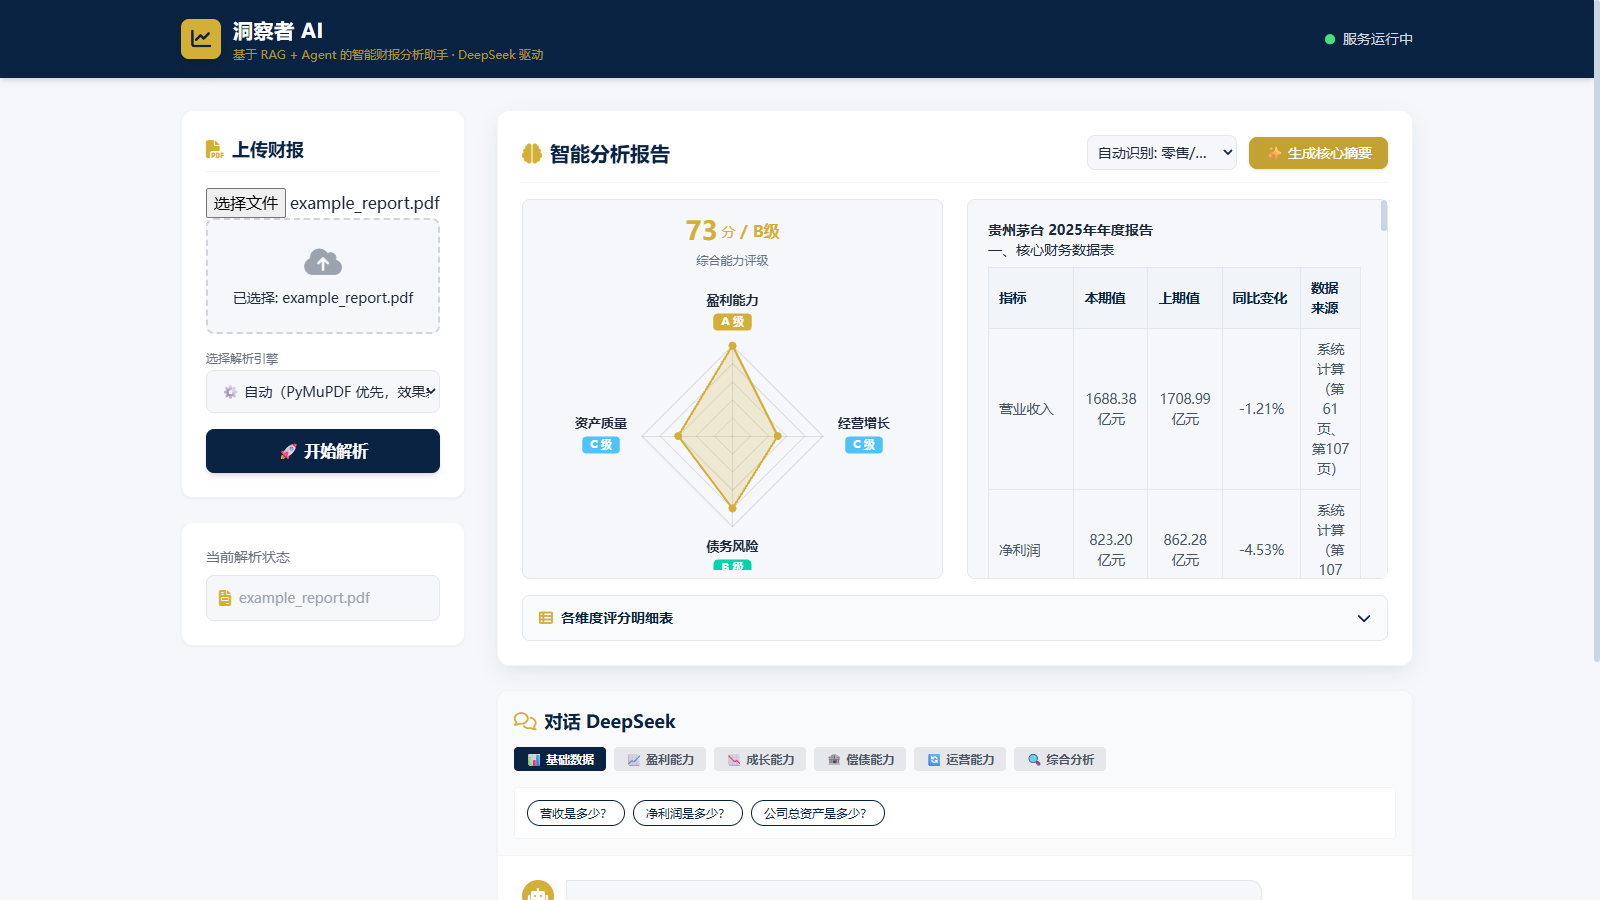
让非金融专业人士读懂上市公司 PDF 财报:上传财报后用自然语言提问,由 LangGraph Agent 调用财务工具算指标、生成摘要与能力雷达图,并标注来源页码。
| 指标 | 结果 |
|---|---|
| Agent 工作流 | LangGraph 闭环:规划 → 工具调用 → 反思 → 重试,最多 5 轮迭代收敛 |
| 工具层 | 封装 19 个财务计算工具 |
| 文档解析 | LlamaParse 混合解析,攻克中文财报 PDF 无边框表格 |
| 部署 | Docker Compose 一键启动,GPU / CPU 依赖分离 + 健康检查 |
仓库:https://github.com/Jerry518520/financial-analysis-AI-assistant
- 失效模式:LLM 的问题大多不报错。防幻觉提示词写了不等于生效——输出脱离检索依据时系统毫无反应。这类非显性失效要靠断言校验和回归测试兜住,不能靠肉眼 review。
- 可验证:指标口径必须先定清楚再谈优化。分母不同的两个指标不能直接比大小,否则优化方向会被自己的数字带偏。
- 工程纪律:宁可让系统拒答,也不要让它编。检索不到依据就返回「没有依据」,比给一个看起来合理的答案是更好的工程选择。
- 邮箱:jerrylbj@foxmail.com
- 求职意向:LLM 应用开发 / AI 应用开发方向实习